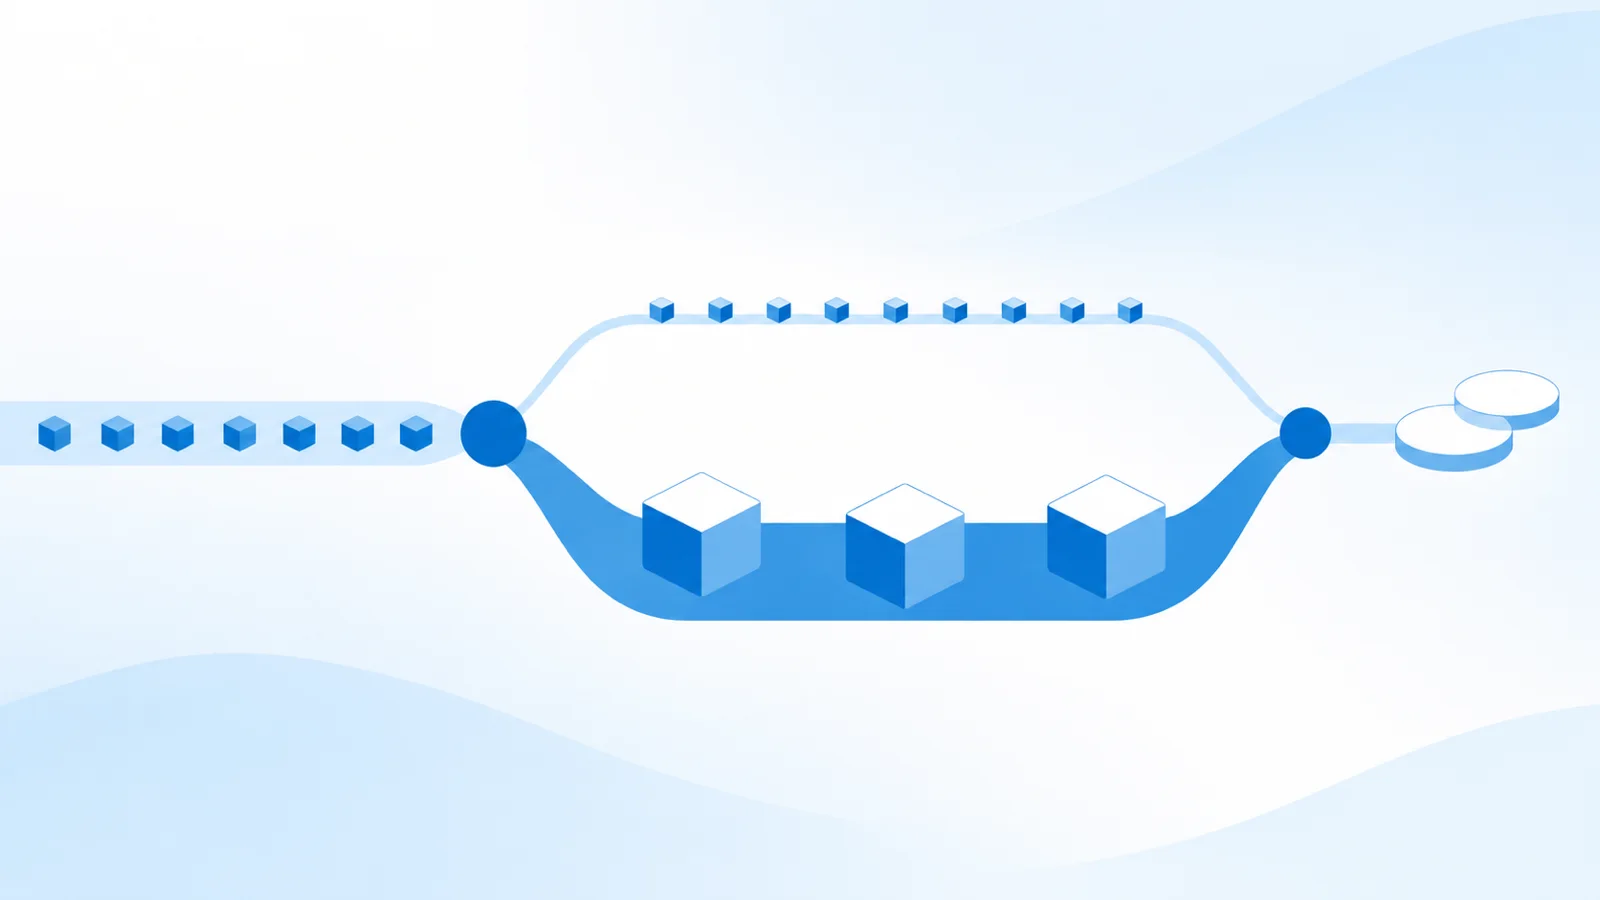
「Gemini は Pro にしておけば安心なのだろうか」。Google のAI「Gemini」には、軽くて安い Flash と、深く考える Pro があります。短い問いに限れば、Google の50問の試験で Pro の費用は Flash を低い設定にしたときの約12倍で、正解は Flash が50問、Pro が48問でした。
Google は2026年11月3日、開発者向けブログで、同じ50問を設定違いの Gemini に解かせた試験の結果を公開しました。問いは、AIエージェント(指示を受けて作業を進めるAI)がプログラムの作業中に受ける短いものです。比べた軸は、トークン(AIが文章を数える単位)の単価ではなく、正解1問あたりの費用でした。
この数字が効くのは、API(自社の仕組みからAIを呼び出す窓口)で使った分だけ払っている会社です。月額の Gemini アプリだけを使う会社には、そのまま当てはまりません。i-Style は Google の試験を再現していないので、公開された数字を読み解き、手元の別の記録を添えて書きます。
先にまとめ
この記事を読むとわかることは、Gemini Flash と Pro の費用の差と、費用を抑えるときの順番です。Google の試験では、Gemini 3.1 Pro の50問の費用は0.32ドルで、Gemini 3.8 Flash を低い設定にした0.026ドルの約12倍でした。正解は Flash が50問すべて、Pro は48問です。Pro の2問は誤答ではなく、回答を断ったものです。
AIの回答の長さに上限を付けても、易しい問いの費用は減らず、難しい問いを7問落としました。効いたのは、考える深さ(thinking level)を初期設定の medium(中)から low(低)に下げることで、費用は約半分になり、正解は50問のままでした。そのうえで判定専用のAIに問いを振り分けさせると、費用はさらに13%、待ち時間は46%減っています。
小さな会社は、1件あたりの費用を測り、考える深さを下げるところから始めるのが現実的です。試験は短い単発の問いだけで、各設定1回の結果なので、長い作業で Pro が要らないとまでは言えません。
Flash と Pro の違いは、料金と考える深さの初期設定
試験に使われた3つのモデルの条件を、2026年11月4日に Gemini API の料金ページと考える深さの説明ページで確かめました。料金は100万トークンあたりの米ドルです。入力はAIに渡す文章、出力はAIが考えたり答えたりする分を指します。Pro は入力が20万トークン以下のときの数字です。
Gemini 3.5 Flash-Lite は入力0.30・出力2.50で、考える深さの初期設定は minimal(最小)です。Gemini 3.8 Flash は入力0.75・出力3.75で、初期設定は medium(中)です。この2つには無料枠があります。3.8 Flash は2027年1月1日から入力1.50・出力7.50に上がります。
Gemini 3.1 Pro Preview は入力2.00・出力12.00で、初期設定は high(高)です。プレビュー版で、無料枠はありません。
読みどころは出力の単価です。AIが答える前に考えた分も出力として請求されるので、同じ答えでも深く考えるほど費用は増えます。Pro の出力の単価は 3.8 Flash の3.2倍です。実際の費用の差は、単価に加えて、それぞれのモデルが考えるのに使った量で決まります。
来年の差は後の節で試算します。なおGemini 4 Argon はこの試験に入っていません。
マメ
うちは8人の会社で、Google AI Pro を2人分契約して、Gemini アプリで資料の下書きをしています。この費用の話は関係ありますか。
ホク
アプリだけなら、ここで比べている API の料金はかかりません。アプリの使える量は、契約しているプランの上限で決まります。関係してくるのは、問い合わせの自動仕分けのように、自社の仕組みから API で呼び出して使った分だけ払う場合です。
マメ
来年、問い合わせの仕分けを外注で作るかもしれません。今のうちに何を知っておけばいいですか。
ホク
見積もりのときに「どのモデルを、どの深さの設定で動かしますか」と聞けるようにしておくことです。その答えで、毎月の費用が何倍も変わることがあります。
Google の50問の試験では、Pro の費用は Flash の低い設定の約12倍
50問は7種類に分かれ、25問が易しい側、25問が難しい側として手で割り当てられています。設定ファイルから値を抜き出す、短く分類する、形式を確かめるといった問いが易しい側です。処理の手順を追う、計算や論理を重ねる、プログラムの細かな不具合を見つける問いが難しい側になります。まず見るのは、次の表の「3.8 Flash・深さ low」と「3.1 Pro」の2行です。
| 設定 | 正解 | 50問の費用 | 正解1問あたり | 平均の待ち時間 |
|---|---|---|---|---|
| 3.5 Flash-Lite だけ | 44/50 | $0.00648 | $0.00015 | 0.61秒 |
| 3.8 Flash・出力の上限300 | 43/50 | $0.04404 | $0.00102 | 3.57秒 |
| 3.8 Flash・初期設定の深さ | 50/50 | $0.05535 | $0.00111 | 3.08秒 |
| 3.8 Flash・深さ low | 50/50 | $0.02632 | $0.00053 | 3.55秒 |
| 3.1 Pro | 48/50 | $0.31970 | $0.00666 | 7.94秒 |
| 語句の規則で振り分け(Flash-Lite と low) | 48/50 | $0.01927 | $0.00040 | 1.90秒 |
| 判定専用のAIで振り分け(Flash-Lite と low) | 50/50 | $0.02287 | $0.00046 | 1.90秒 |
Pro と 3.8 Flash の low を比べると、50問の費用で約12倍、正解1問あたりでは約12.6倍の差があります。Pro が落とした2問は、プログラムの安全性の確認を頼む短い問いで、Flash が答えた問いを Pro の設定が断りました。Google は、安全性の確認をさせるなら使う予定の設定で試すよう勧めています。
表には読み違えやすい所もあります。正解1問あたりだけを見ると Flash-Lite が最安ですが、50問中6問を外していて、どれも難しい側の問いです。外した分のやり直しや確認の手間は、この数字に入っていません。費用は正解の数と並べて読みます。
i-Style でも、モデルを比べるときに同じ見方をしています。経理の小さなプログラム3つを各3回作らせて隠しテストで採点した Claude Sonnet 5 と 5.5 の比較では、使った量を料金表で換算すると、5.5 はプログラム1回の作成の費用が15%増えた一方、テスト1問の正解あたりでは16%減りました。作成1回の費用だけを見ていると、逆の判断をしていたところです。
出力の上限を下げると7問落ち、考える深さを下げると費用は約半分
費用を抑えようとして最初に思いつくのは、AIの回答の長さの上限(maxOutputTokens)を小さくすることかもしれません。Google はこれを 3.8 Flash で試しています。判定専用のAIが易しいと判定した27問(人の割り当ての25問とは少しずれます)では、上限を300トークンにしても4096トークンのままでも、考えた量はほぼ同じでした。費用はむしろ0.01957ドルから0.02018ドルへ少し増えています。
上限は天井でしかなく、易しい答えはそこまで届きません。その一方で、難しい25問のうち7問は正しく答えられませんでした。6問は考えている途中で上限に達して答えが出ず、残る1問は考えを縮めて誤答になっています。50問全体の費用は0.04404ドルに下がりますが、正解は43問に減りました。
効いたのは深さの設定です。API で thinkingLevel を low にすると、同じ27問の費用は0.00496ドルと、初期設定の深さの0.01957ドルの約4分の1になりました。50問全体でも0.05535ドルから0.02632ドルへ52%減り、正解は50問のままです。Google はこの設定を、振り分けを作る前にまず試すものとして挙げています。
Claude にも同じ考え方の設定(effort)があります。i-Style が Opus 5.5 で5段階を比べたときは、最も低い low でも正解は9割以上で、最も高い max の時間は平均で low の10倍以上でした。モデルも課題も別なので数字は比べられませんが、深く考えさせるほど良いとは限らない点は共通しています。
振り分けが縮めるのは、費用より待ち時間
次の段階が、問いごとに使うモデルを切り替える振り分けです。Google の試験では、TypeSafe 社の Jev という判定専用のAIを前に置きました。Jev は文章を書かず、選択肢や真偽を確率つきで返します。料金は入力100万トークンあたり0.042ドルで、出力は無料です(11月4日確認)。原典は、Google と TypeSafe に提携は無く、推薦でもないと断っています。
Jev が易しいと見た問いを Flash-Lite に、難しいと見た問いを 3.8 Flash の low に回した結果、正解は50問すべてで、費用は全問 low より13%少ない0.02287ドルでした。平均の待ち時間は3.55秒から1.90秒へ46%縮んでいます。Google 自身も、この短さの問いでは費用の差は小さく、対話で使うなら待ち時間のほうが大きな利点だと書いています。
AIを使わず、語句で振り分ける方法も比べられていますが、初めて見る問いでは一致が落ちました。特定の語や35語を超える長さで難しさを決める規則は、調整に使った16問では15問が人の割り当てと一致しました。初めて見る34問では24問(70.6%)にとどまり、Jev は34問すべて一致しています。規則の振り分けは費用こそ0.01927ドルでしたが、難しい問いを Flash-Lite に流して2問落としました。
判定の聞き方でも結果は変わります。「易しいか難しいか」と1問で聞くと、ほぼ全部が易しい側に寄りました。「答えるのに2段階以上の計算や推論が要るか」という真偽の問いに替えると、きれいに分かれています。i-Style でも、AIの回答文に判断が文章のまま残っていないかを Jev に点検させたとき、1問で聞くと当てはまる確率(0〜1)は0.65でしたが、3問に分けて一番高い値を取ると0.9を超えました。
振り分けで注意したい点は2つあります。1つは、難しい問いをさらに重い設定へ回しても得にならなかったことです。Flash-Lite と初期設定の深さの組み合わせは0.03728ドルで、全問 low より高くつきました。
もう1つはキャッシュ(同じ文面を送り直すときの割引)です。原典によれば、送り直す分は75〜90%安くなります(料金ページの3モデルでは入力の単価の10分の1です)。ただしキャッシュはモデルごとに分かれるため、やり取りの途中でモデルを替えると、同じ内容を別々に保存するか、割引を受けられなくなります。振り分けるのは短く単発の問いだけにして、長い文脈を持ち回る作業は1つのモデルに固定するのが原典の勧めです。
マメ
問い合わせの自動仕分けを1日50件くらい流す予定です。担当は私1人で、作る時間は週に2時間しか取れません。振り分けまで作るべきですか。
ホク
費用だけが理由なら、先に深さを下げるだけで足ります。1件が試験と同じ短さだとして月1,500件で計算すると、全問 low で約0.8ドル、振り分けで減るのは0.1ドルほどです。
マメ
では、どんな時に振り分けを考えればいいですか。
ホク
お客様が画面の前で答えを待っていて、応答を速くしたい時です。裏で流す仕分けなら、数秒の差は問題になりにくいです。
i-Style の振り分けでは、最も安いモデルを選ぶ判定は647回中9回
i-Style では、Google の試験とは別の場所で Jev を使っています。Claude Code(作業を任せられるAIのツール)が別のAIに仕事の一部を任せるとき、Jev が作業名と依頼文を読み、Claude のモデルの Haiku・Sonnet・Opus のどれが合うかを判定する仕組みです。確信度(判定の自信を0〜1で表す数字)が0.6以上のときだけ、その判定を採用しています。
2026年11月4日に、9月23日からの記録を数えました。判定は647回で、Opus が338回、Sonnet が300回、最も安い Haiku は9回(1.4%)です。採用された289回の内訳は、Opus 193回、Sonnet 92回、Haiku 4回でした。
Google の試験は半分が易しい問いでした。i-Style で別のAIに任せる仕事は、作業名にレビュー・点検・調査などの語が入るものが647回中467回(72%)あり、判定で最も安いモデルが選ばれることはほとんどありません。ただし判定が正しかったかは採点しておらず、費用がいくら減ったかも測っていないので、この数字から振り分けの効果は言えません。Google の試験とはモデルも判定の仕方も違うので、偏りの原因までは比べられません。振り分け先の偏りは、自社の仕事で数えてみないと分からない例として読んでください。
判定の半分以上(358回)は、確信度が足りずに採用されませんでした。入力は日本語です。TypeSafe の案内は、英語が最も精度が高く、他の言語は同じ精度ではないので自社の文面で試すよう書いています。Google の試験の一致率を、日本語の業務にそのまま当てはめないほうが安全です。
仕事が一種類の決まった仕分けなら、判定を挟まず安いモデルに決め打ちする手もあります。i-Style が Claude Code の読み込む設定を絞り、答えの決まった20件の仕分けを Haiku 5.5 と Sonnet 5.5 で試したときは、どちらも全問正解でした。同じ20件をくり返した2回目以降の費用は、Haiku 5.5 が Sonnet 5.5 の約18分の1です。
小さな会社は、1件あたりを測って考える深さを下げるところから
最初にやるのは測ることです。依頼の件数、入力と出力(考えた分を含む)のトークンの量、キャッシュの読み込みの量、正しく終わった件数を記録します。それぞれに単価を掛け、やり直しや振り分けの費用も足した総費用を正しく終わった件数で割れば、1件あたりの費用が出ます。Google も、どの作業が費用を押し上げているかを記録で確かめるよう勧めています。
次に、考える深さを low にして同じ依頼を流し、正解が落ちる種類の作業だけ深さを戻します。節約のために出力の上限を縮めることはしません。深さを戻しても必要な正解率に届かない作業が残ったら、そこで Pro を試します。
振り分けを作るかは件数で判断できます。試験と同じ短い問いを月1万件流すと仮定し、50問の費用を200倍すると、全問 low は約5.3ドル、Jev の振り分けは約4.6ドル、Pro は約64ドルです(i-Style の試算)。大きいのは Pro から Flash へ替える差で、振り分けで減るのは月0.7ドルほどにとどまります。実際の問いが長ければ金額は増えますが、費用だけを理由に振り分けを作ると、作る手間のほうが高くつきそうです。お客様が画面の前で答えを待つ場面なら、待ち時間の短さを理由に検討できます。
もう1つ、3.8 Flash の料金は2027年1月1日に入力・出力とも2倍になります。同じ試験なら、low の50問は約0.053ドルになり、Pro との差は約12倍から約6倍に縮む見込みです(i-Style の試算)。
この試算は、試験の費用が今の料金で計算されたものと見て出しました。low の考えた分6,187トークンだけで、出力100万トークンあたり3.75ドルなら約0.023ドル、7.50ドルなら約0.046ドルとなり、後者は50問の費用0.02632ドルを超えるからです。それでも Flash のほうが安いので順番は変わりません。来年も使う仕組みなら、費用の見積もりは新しい料金でも出しておくと安心です。i-Style では、モデルの名前で選ぶ前に、こうして自社の依頼1件あたりで数えておくことが後から効いてくると見ています。
確かめた資料は Google の試験と公式の料金ページ、未確認は長い作業と日本語
試験の内容は、Google Developers Blog の記事「Cost per task」(2026年11月3日公開)を原文で読みました。数字は本文と、記事内の表の画像から書き写しています。
Google が挙げる限界は、各設定1回の実行、50問、難しさは手で割り当て、採点は簡易な自動採点という点です。待ち時間は2回の試験にまたがるので、初期設定の深さの Flash や Pro との比較は目安と断っています。試験のコードは公開予定とされており、i-Style は再現していません。
料金と設定は、Gemini API の料金ページ、考える深さの説明ページ、TypeSafe のモデルの案内を2026年11月4日に確認しました。契約や開発の前に、最新の料金を確かめてください。
確かめていないのは、長く続く作業での Flash の low と Pro の差、日本語の問いでの正解率、Gemini アプリでの使い心地の違いです。i-Style の647回は普段の運用の記録で、判定の正しさと費用の減り方は測っていません。
i-Styleに相談する
i-Styleの「まるっとAI」は、業務の自動化支援やAI活用支援を月額制でお手伝いするサービスです。どの作業にどのモデルを使い、毎月の費用をどう見積もるかの整理からご相談いただけます。
お問い合わせページへ arrow_forward相談するほどではない段階なら、右下のチャット窓口で「自社の仕事にどのモデルが合うか」を聞いてみるところからでも十分です。